음성 인식
Whisper 모델이 내 컴퓨터에서 음성을 문장과 단어로 나눕니다.
영상 · 자막 편집
Windows · macOS 12.0+
자막을 보면서 영상을 자르세요.
내 컴퓨터에서 음성을 문장·단어 자막으로 바꾸고, 필요 없는 말을 고르면 그 부분의 영상과 소리를 함께 자릅니다. 자막 시간과 무음을 다듬은 뒤 MP4·SRT·VTT로 내보냅니다.
01 · 말이 많은 영상
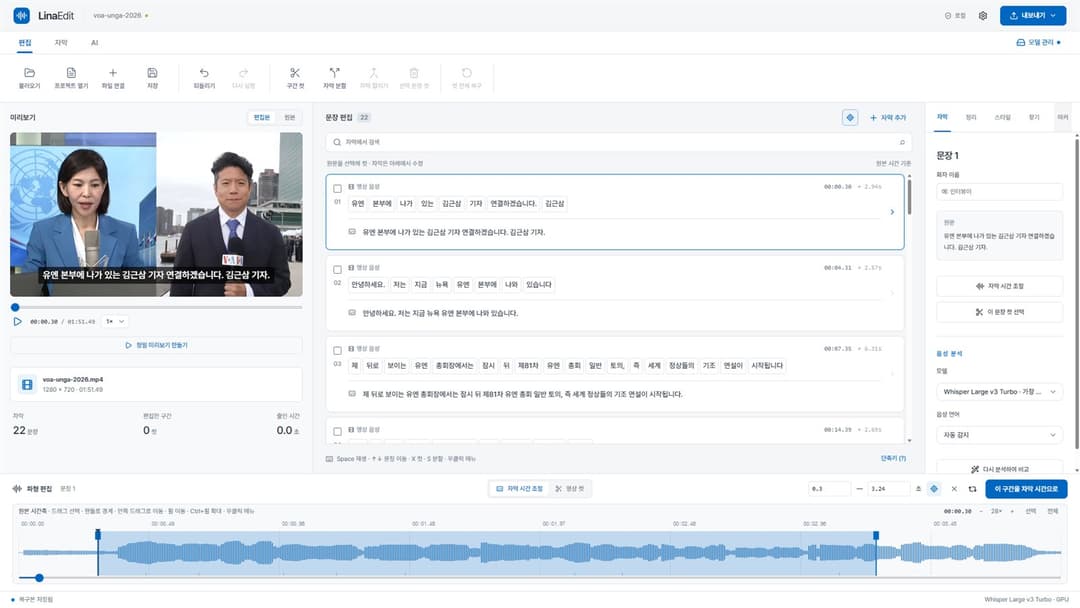
영상을 불러와 음성 인식을 실행하면 전사한 문장과 단어가 영상·파형과 연결됩니다. 영상 컷과 자막 표시 시간은 서로 다른 모드에서 조절하므로, 장면은 그대로 두고 자막 타이밍만 맞출 수도 있습니다.
Whisper 모델이 내 컴퓨터에서 음성을 문장과 단어로 나눕니다.
필요 없는 말을 골라 영상과 소리를 함께 자릅니다.
자막과 무음을 정리한 뒤 MP4·SRT·VTT로 내보냅니다.
02 · 주요 기능
10 장면 · Microsoft Store
컷 편집
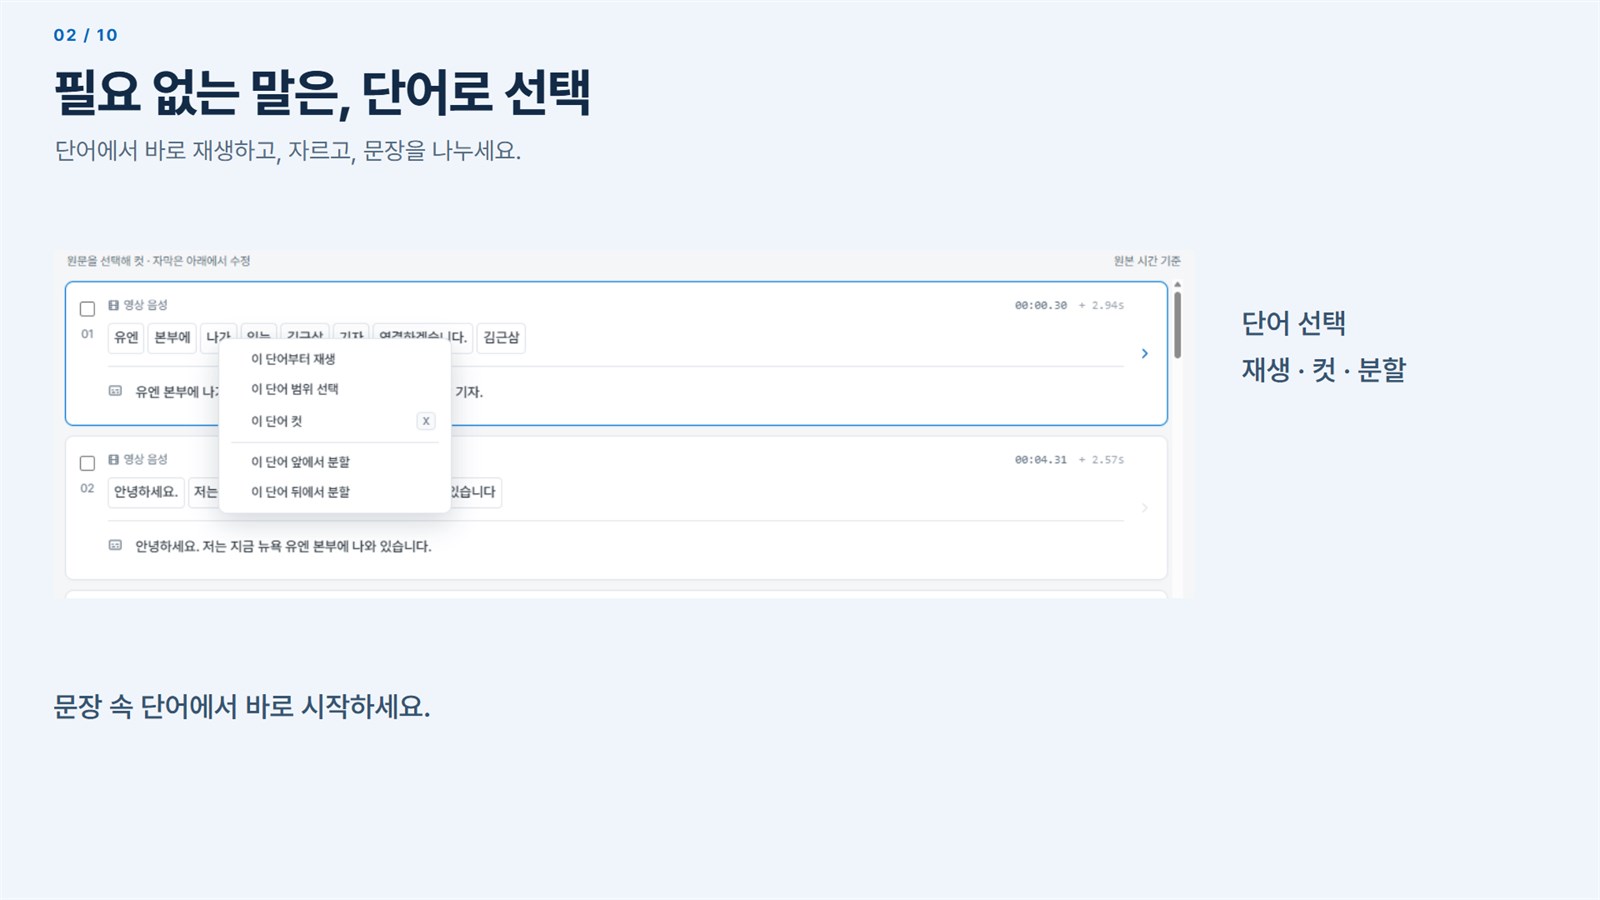
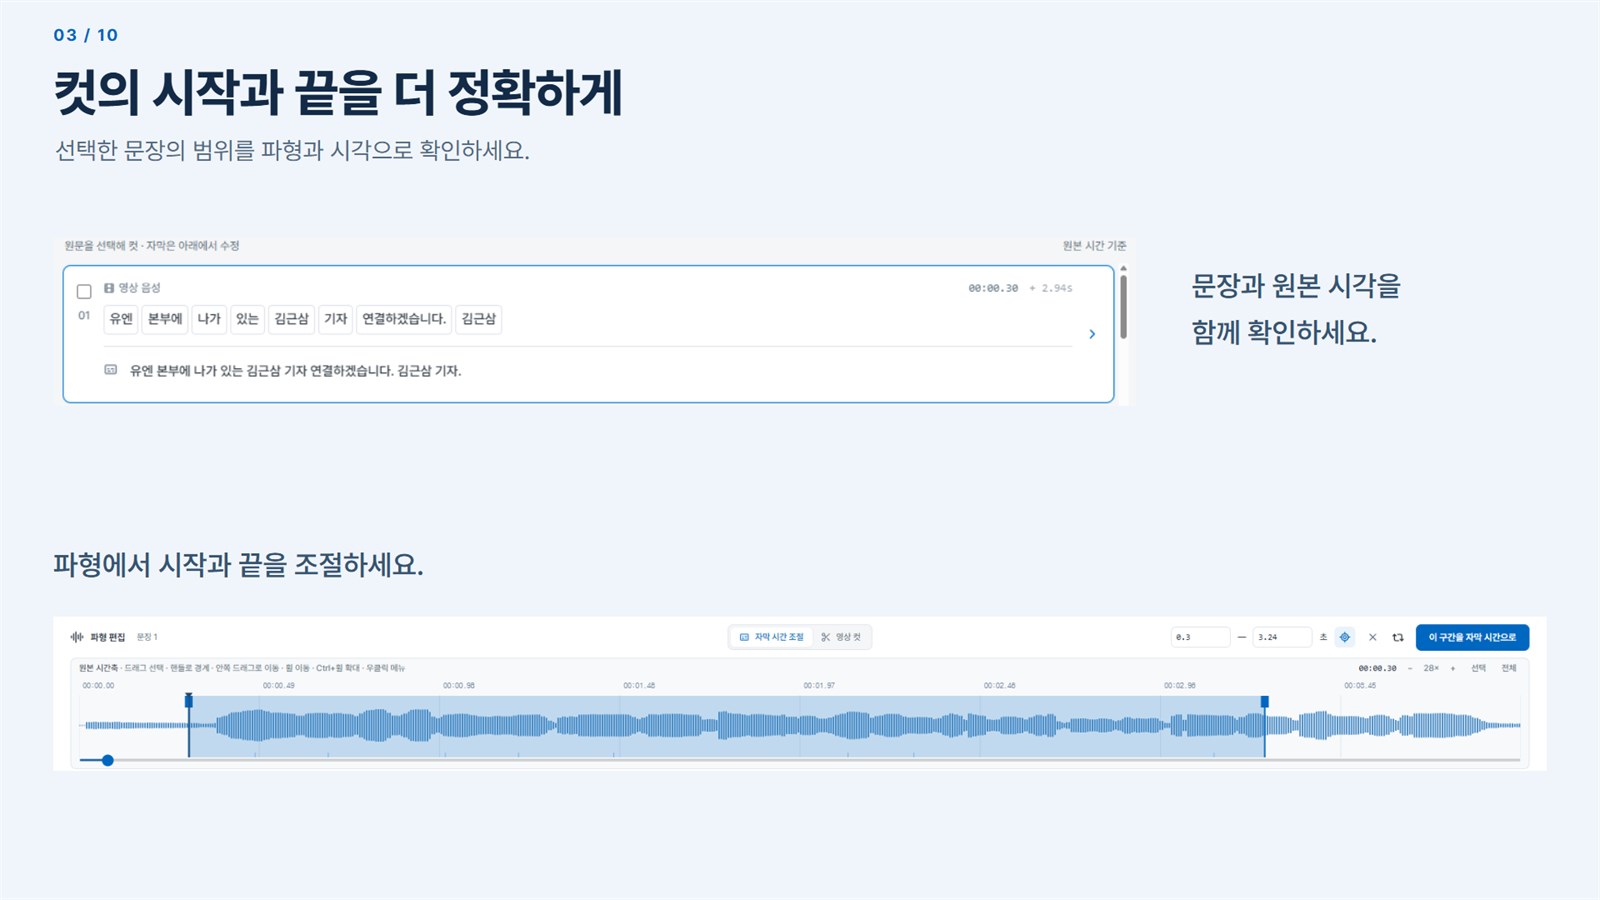
전사한 단어마다 재생·선택·컷·분할 메뉴가 있습니다. 경계가 애매하면 파형을 확대하고 핸들을 드래그해 프레임 단위로 맞춥니다.
다듬기
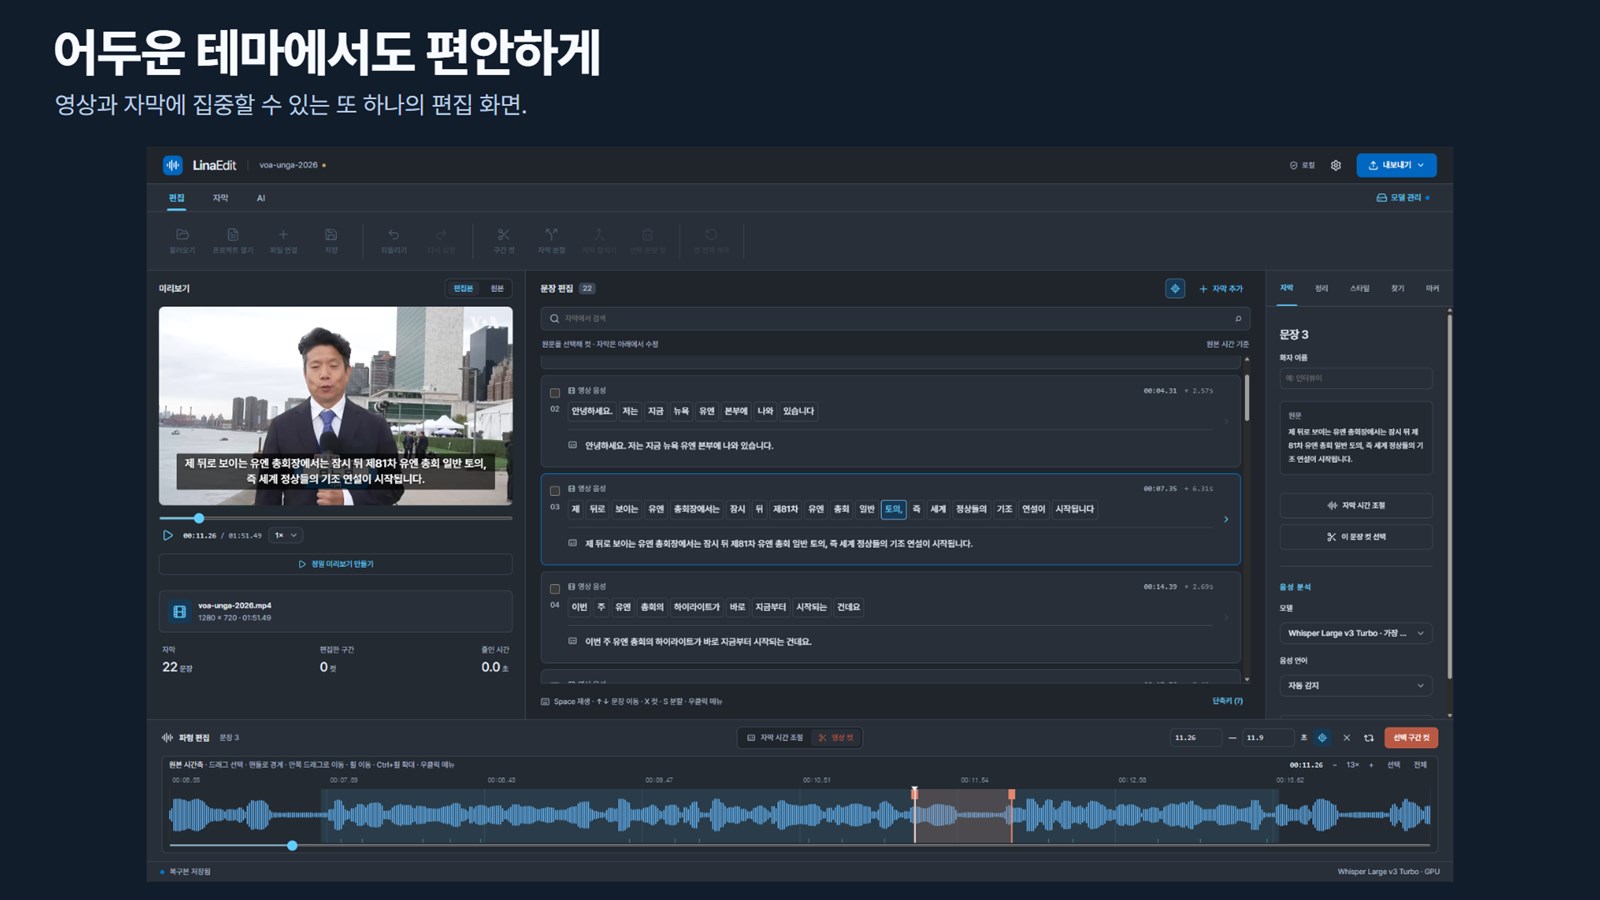
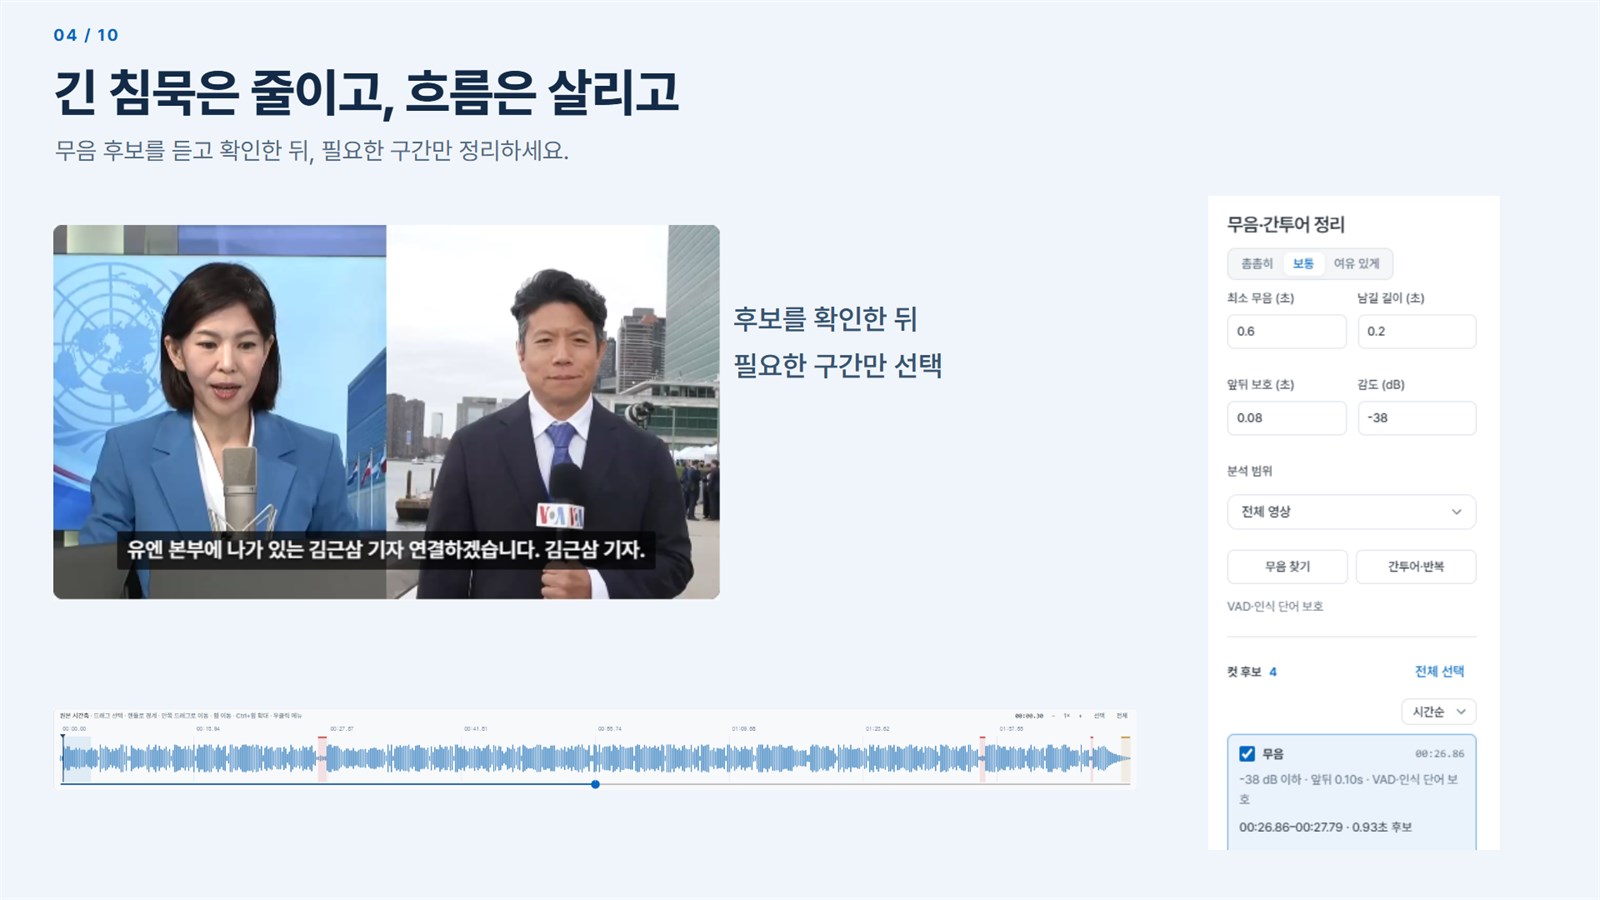
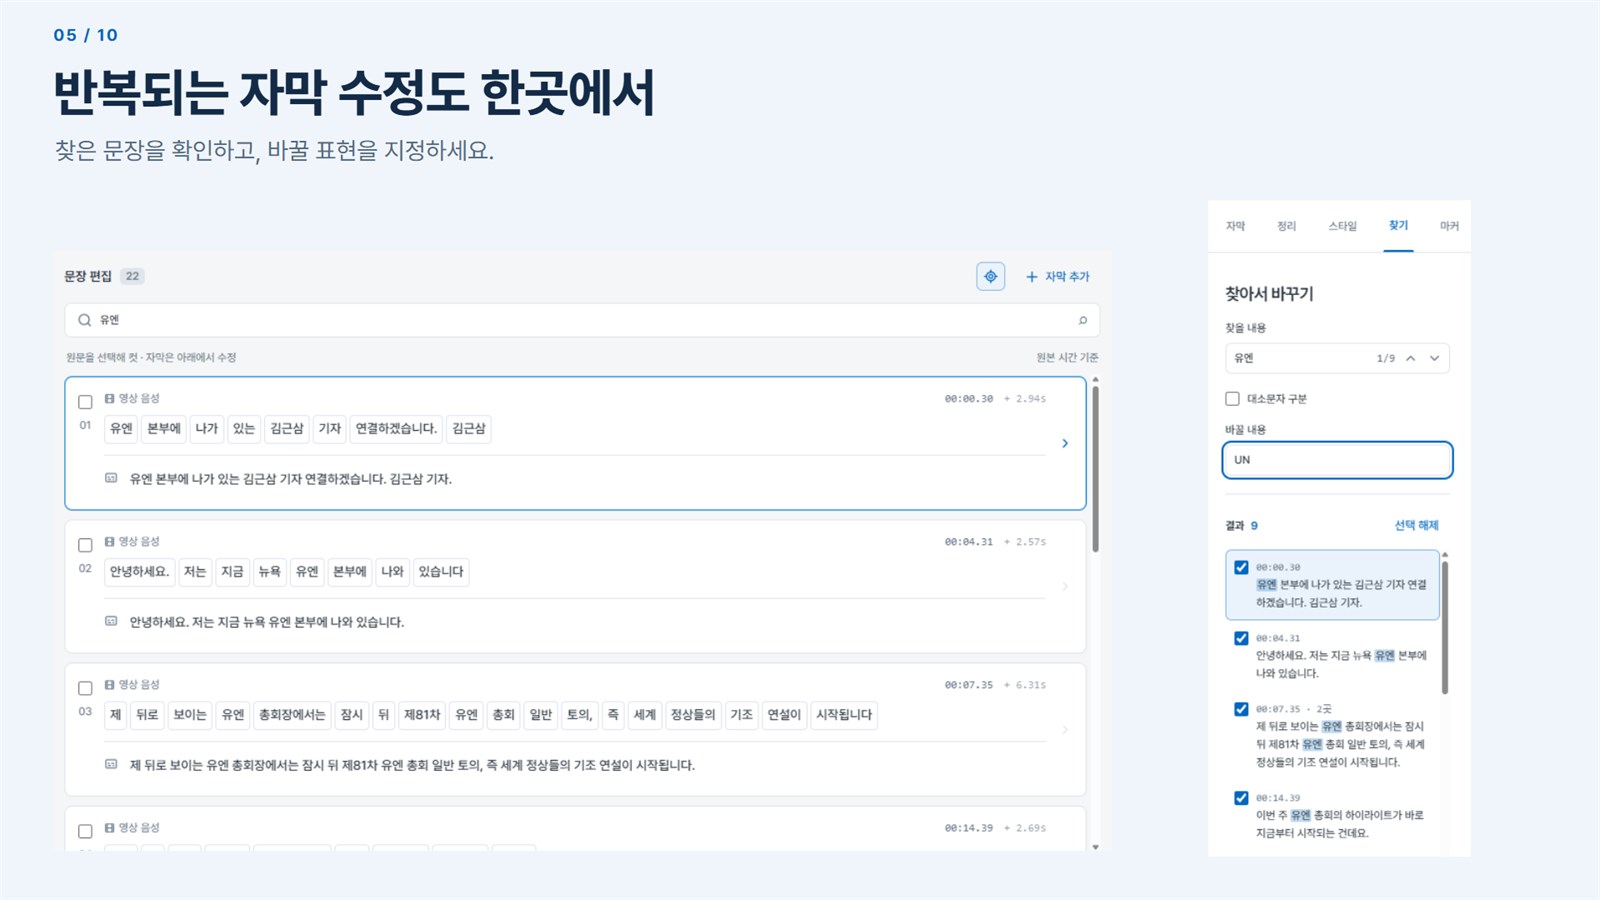
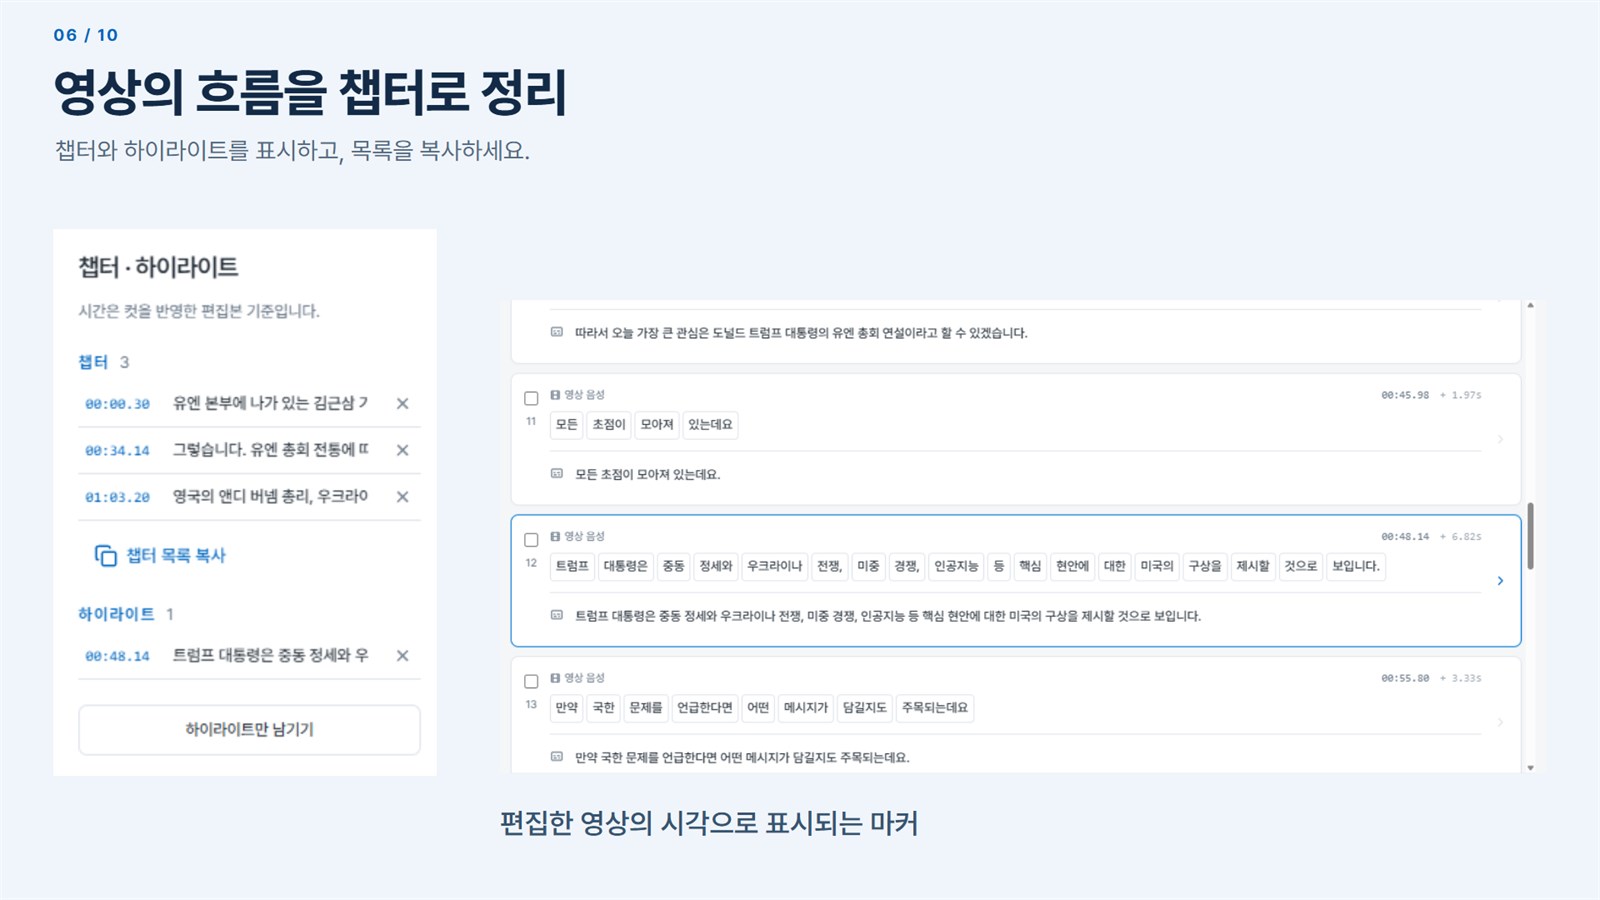
무음과 “음·어” 같은 간투어는 후보로 먼저 보여 주고, 컷 전후를 들어 본 뒤 고른 것만 적용합니다. 자막 속 표현은 결과를 보며 골라 바꾸고, 주제가 바뀌는 문장에는 챕터를 표시합니다.
자막과 출력
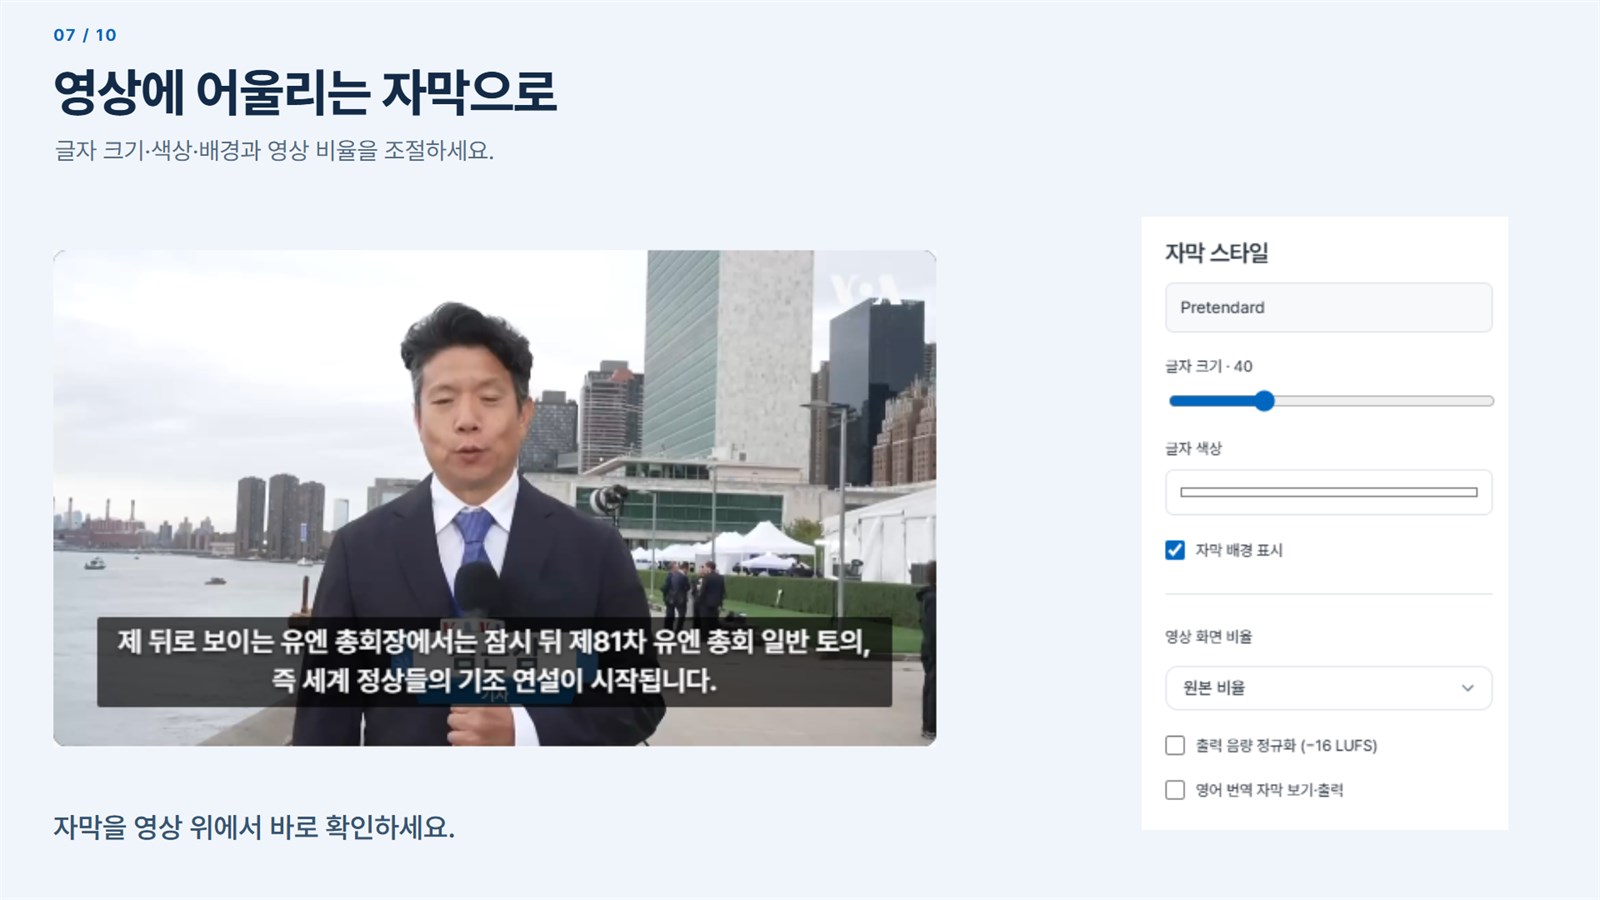
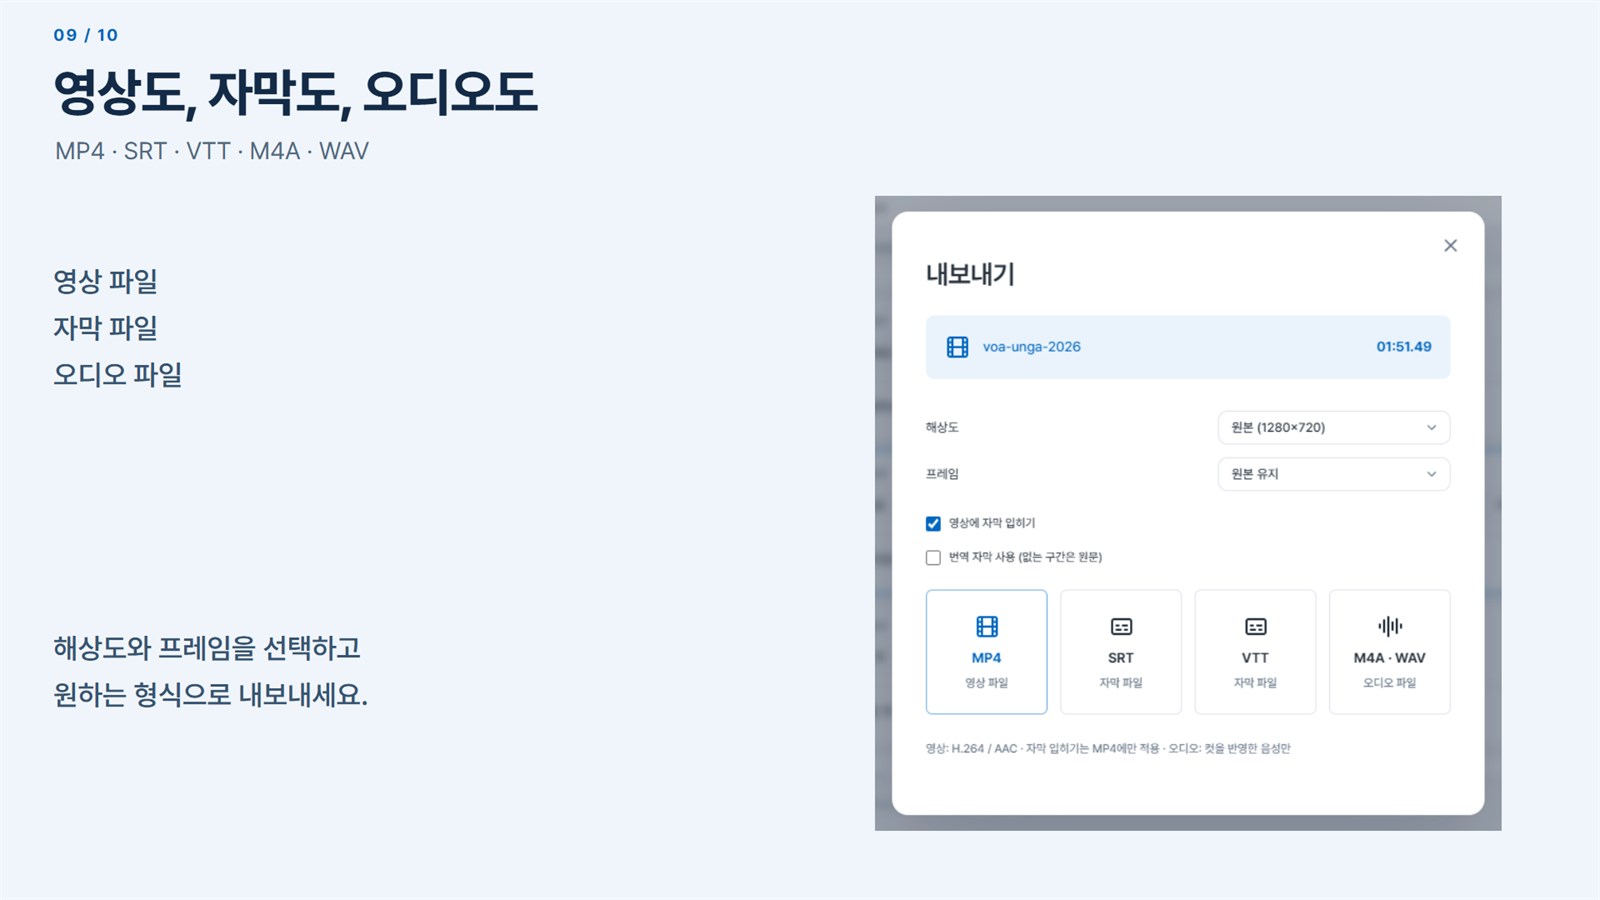
화면 비율은 16:9·9:16·1:1 가운데 고르고 출력 음량을 정규화할 수 있습니다. 자막을 입힌 MP4나 SRT·VTT 자막, 편집한 음성만 담은 M4A·WAV로 내보냅니다.
로컬 AI
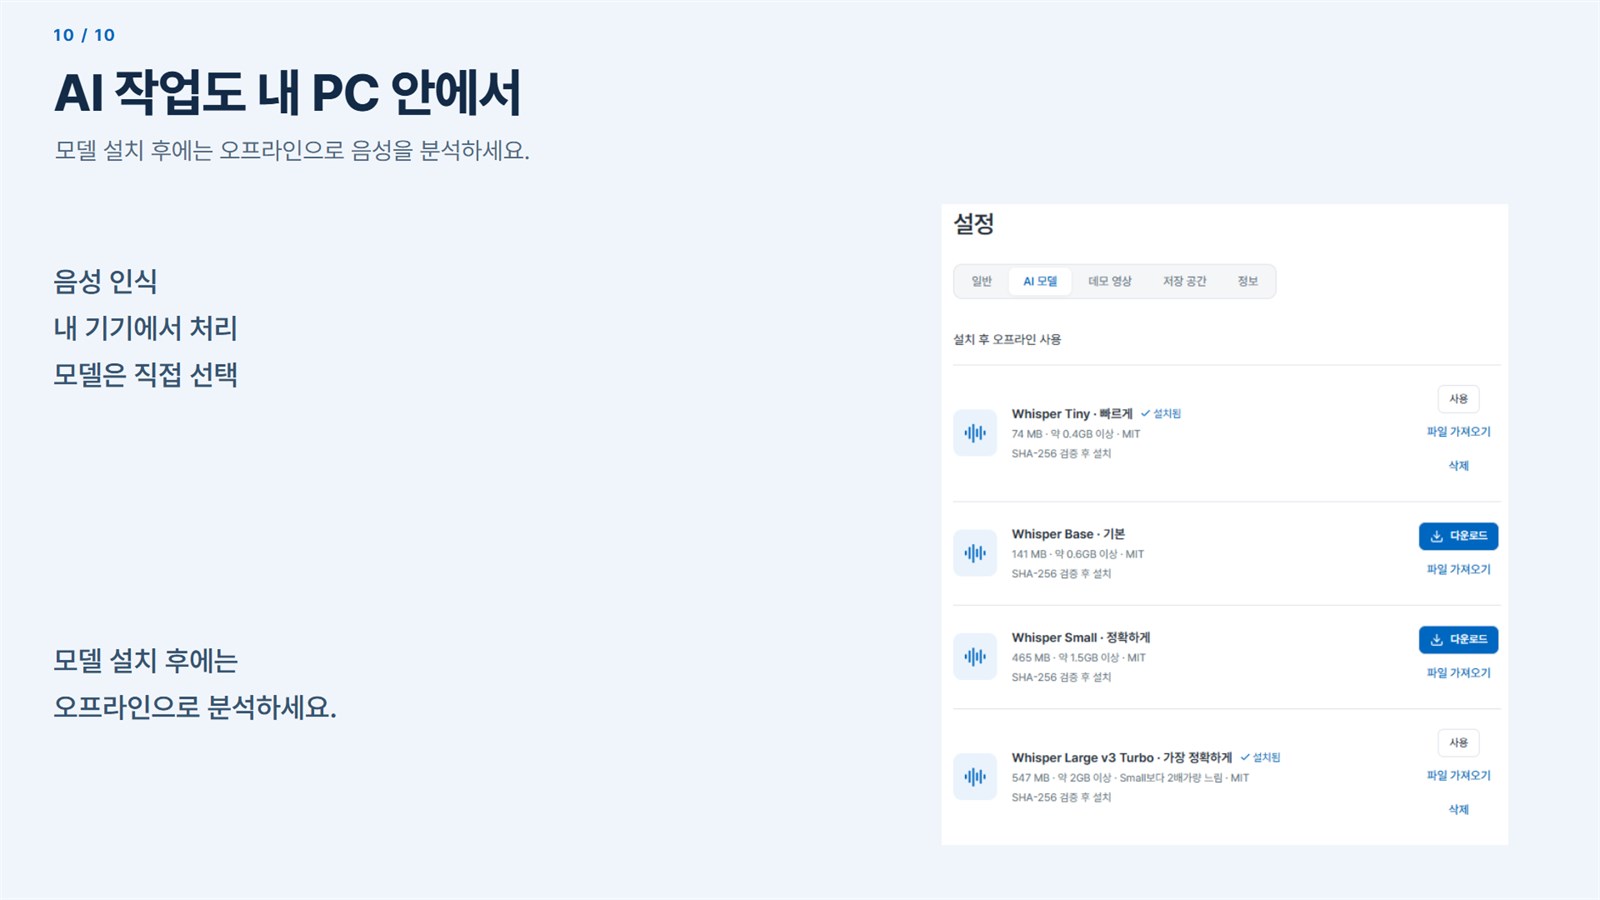
Whisper 모델은 크기와 정확도를 보고 골라 내려받거나 파일로 가져옵니다. 별도로 설치한 Qwen 모델의 자막 교정·챕터 제안도 내 기기에서 실행되며, 비교한 뒤 고른 것만 적용합니다.
03 · 이런 영상을 위해
인터뷰, 강의, 설명 영상, 토크 영상처럼 말의 흐름이 중요한 작업에 맞췄습니다.
긴 인터뷰에서 필요한 발언만 남길 때
강의 영상의 쉼과 간투어를 정리할 때
쇼츠·릴스용 세로 자막 영상을 만들 때
04 · 개인정보 보호
음성 인식과 편집, 내보내기는 설치한 모델로 내 컴퓨터에서 처리합니다. 계정이나 영상 업로드가 필요 없고, 인터넷은 AI 모델이나 데모 영상을 직접 내려받을 때만 사용합니다.
내 컴퓨터에서 처리합니다
클라우드 처리, 로그인, 광고, 분석 도구가 없습니다. 인터넷은 모델이나 데모 영상을 내려받을 때만 사용하며, 영상·자막·프로젝트는 내 컴퓨터에 남습니다.
05 · FAQ
음성 인식 모델이나 데모 영상을 내려받을 때만 필요합니다. 설정에서 모델을 내려받거나 파일로 가져온 뒤에는 분석과 편집을 오프라인으로 진행하며, 계정이나 영상 업로드는 필요하지 않습니다.
한국어·영어·일본어·중국어·스페인어·프랑스어·독일어·베트남어·인도네시아어를 인식하거나 언어를 자동 감지합니다. Whisper로 영어 번역 자막도 만들 수 있습니다.
깨끗한 녹음은 작은 모델로도 잘 인식되고, 잡음이 많다면 Small 모델을 권장합니다. Small 이상 모델은 메모리 8GB 이상을 권장하며, 인식 결과는 녹음 품질과 배경음에 따라 달라지므로 내보내기 전에 자막과 컷을 확인하세요.
아닙니다. 원본 파일은 수정하지 않습니다. 편집 내용은 자동 저장되며 복구 기록, 이전 저장본 백업, 옮긴 원본 재연결을 지원합니다.
Microsoft Store와 Mac App Store에서 만나보세요.
데스크톱 제품